Git から同期しているアプリケーション 12 件

Git 管理 · 最終確認 2026年8月

信頼できる基盤をつくり、デプロイも復旧も予測どおりに。

ベアメタルの Proxmox ホスト 1 台の上で 4 ノードの K3s クラスタを運用し、 その上で実際に使われているプロダクトを開発・運用しています。Terraform・Ansible・ArgoCD により、すべての変更を再現可能にしています。

クラスタノード
4
同期アプリ
12
稼働サービス
20+
決済から起動まで
46

プロビジョニングの流れ

ベアメタルから稼働まで

図 1 — パイプライン すべての層を Git で宣言
  1. Proxmox 物理ホスト 1 台
  2. Terraform + Ansible VM 5 台を作成し、設定を適用
  3. K3s 4 ノード構成(コントロールプレーン 1)
  4. ArgoCD Git から 12 アプリを同期
  5. アプリケーション MetalLB と Longhorn 上で 20 以上のサービス

監視

Prometheus · メトリクスと自作エクスポーター

Grafana · ワークロードごとのダッシュボード

Alertmanager · Discord へ通知

プロジェクト

主要 3 件 · 小規模 3 件

kubernetes-platform 稼働中

インフラストラクチャ

セルフホスト型 Kubernetes 基盤

Proxmox ホスト 1 台の上で動く 4 ノードの K3s クラスタ。すべての層を Git で宣言しています。

詳細を見る
課題
1 台のサーバー上で 20 以上のサービスを運用しており、変更はすべて手作業でした。再現性がなく、作り直すには文書化されていない手順を一つずつ思い出す必要がありました。
実装内容
Terraform で VM を作成し、Ansible で 4 ノードの K3s クラスタを構築、ArgoCD がすべてのワークロードを Git から同期します。あわせて MetalLB と Nginx Ingress、スケジュールスナップショット付きの Longhorn、TLS のための cert-manager 内部 CA、自作エクスポーターと Discord 通知を含む Prometheus / Grafana / Alertmanager を構成しました。
成果
12 のアプリケーションを Git から同期し、構成のずれは自動で修正、本番反映はプルリクエスト経由です。作り直しは「週末仕事」ではなくパイプラインの実行になり、復旧手順書は実際の障害で検証済みです。
  • Terraform
  • Ansible
  • K3s
  • ArgoCD
  • Prometheus
  • 構成図
  • 詳細説明はご要望に応じて
  • リポジトリは非公開
クラスタ構成

クラスタ構成

Proxmox ホスト — 物理マシン 1 台

  • k3s-master コントロールプレーン · VM
  • k3s-worker-1 ワーカー · VM
  • k3s-worker-2 ワーカー · VM
  • k3s-worker-3 ワーカー · VM

wings-vm · Docker ホスト(クラスタ外)

  • MetalLB + Nginx Ingress · 安定したアドレス割り当て
  • Longhorn · レプリケーションとスケジュールスナップショット

Longhorn はクラスタ内の VM 間でレプリケーションを行いますが、物理の Proxmox ホスト自体は単一障害点のままです。

1 台のホスト上に VM 5 台。うち 4 台がクラスタ、1 台がゲームサーバー用です。

図 2 — アプリケーション 1 件の構成

図 2 — アプリケーション 1 件の構成 リソースグラフ:homelab リポジトリが vaultwarden の ArgoCD アプリケーションを構成し、Deployment・Service・Ingress・Certificate・PVC を保持します。それぞれ Pod、内部 CA が発行した TLS Secret、Longhorn ボリュームへとつながります。 GIT ARGOCD RESOURCES RUNTIME repo homelab application vaultwarden deployment vaultwarden service vaultwarden ingress · https vaultwarden certificate · cert-manager vaultwarden-tls pvc · longhorn vaultwarden-data pod vaultwarden secret · issued by the internal CA vaultwarden-tls volume · daily snapshot, retain 7 longhorn
12 件のうちの 1 つ、vaultwarden アプリケーションと ArgoCD が同期するリソース一式です。TLS を担う cert-manager の証明書と、データを保存する Longhorn のボリュームまで含みます。
wyrmhost 開発中

プラットフォーム自動化

WyrmHost

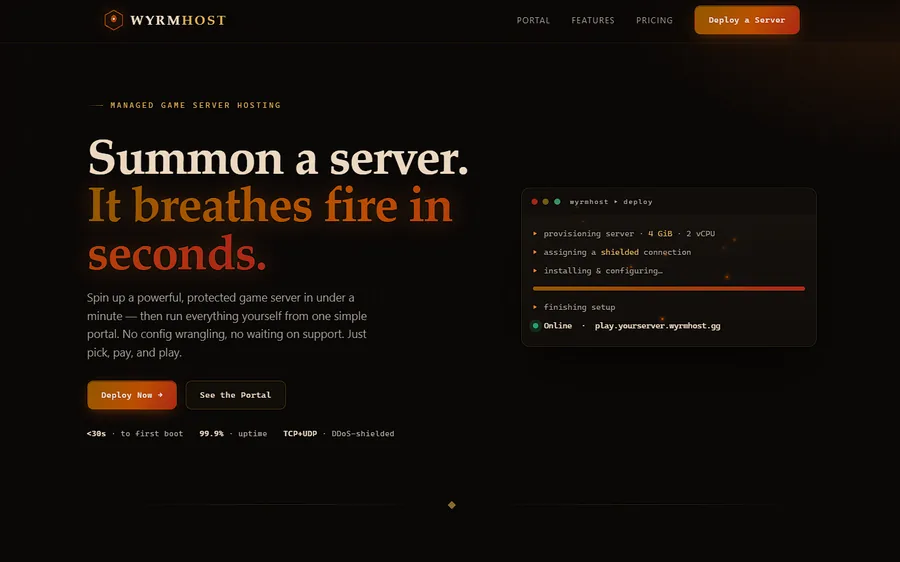
自動でサーバーが用意されるゲームサーバーホスティング。プランを選んで決済すると、そのまま起動します。

詳細を見る
課題
ゲームサーバーを販売するには、注文ごとにサーバーを用意する必要があります。手作業では規模を拡大できず、夜間の注文にも対応できません。
実装内容
ストアフロント、Stripe 決済、キューワーカー、そしてサーバーを作成・起動するパネル API 呼び出しまでを構築しました。利用しているパネル向けのプロバイダーが存在しなかったため、API に合わせて自分で移植しています。環境ごとに独立した GitOps リポジトリを持ち、ArgoCD のガードレールと手動プロモーションで本番へ反映します。
成果
決済からプレイ可能なサーバー起動まで約 46 秒、手作業はゼロです。以前は新規サーバーが初回起動のたびに落ちる原因だったライセンス同意も、自動で処理されます。
  • Laravel
  • Stripe
  • Docker
  • ArgoCD
  • REST API
プロビジョニングの手順
  1. 決済 プランを選んで支払い
  2. 請求確定 プロビジョニングジョブを投入
  3. サーバー作成 ポート割り当てとファイル配置
  4. ライセンス同意 自動処理のうえ起動
  5. 起動完了 接続可能 — 合計約 46 秒
実際のテスト購入で計測しました。
WyrmHost のストアフロント。「Summon a server. It breathes fire in seconds.」という見出しと Deploy Now ボタン、サーバーが起動していく様子を示すデプロイコンソールが並ぶ暗い配色のページ。 ストアフロントの原寸画像を開きます(新しいタブ)
お客様が購入する画面。上の手順の入口にあたります。
wyrmtable 公開中

プロダクト · フルスタック

Wyrmtable

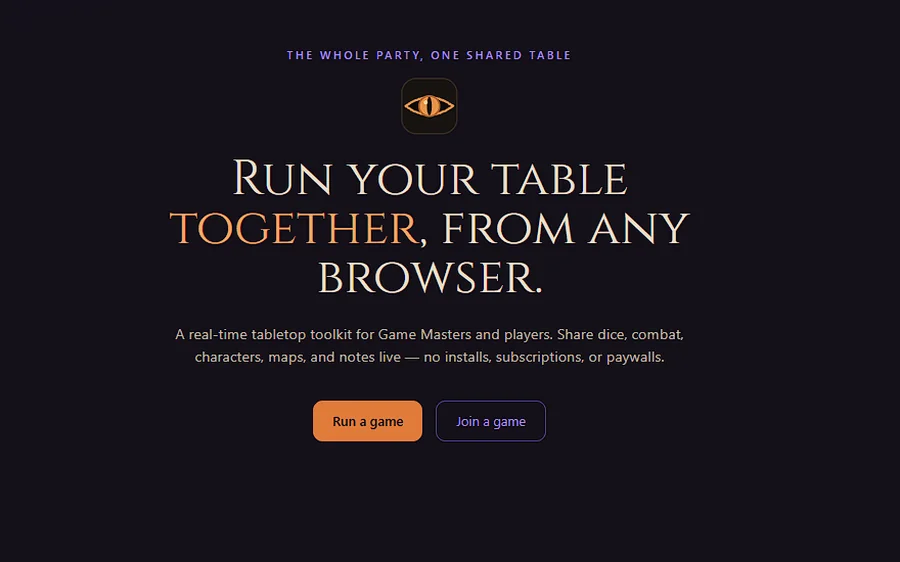
テーブル全体で 1 つのゲーム状態を共有できる、リアルタイムの TRPG ツールです。

詳細を見る
課題
TRPG 用のツールは 1 台の端末で動くものが多く、参加者全員が同じ画面をのぞき込む形になります。各自の端末へリアルタイムに状態を共有できるものがありませんでした。
実装内容
WebSocket でテーブルの状態を共有し、サーバー側で判定するダイス、戦闘トラッカー、キャラクターインポートを備えたブラウザツールです。コンテナ化、バージョン管理されたマイグレーション、失敗を検知するアラート付きの夜間バックアップ、専用の Grafana ダッシュボードまで、開発と運用のすべてを担当しています。
成果
wyrmtable.eu で一般公開中です。ポートを開放せず Cloudflare Tunnel 経由で公開し、Pod は NetworkPolicy で制限、非 root で実行、認証にはレート制限をかけています。リリースはイメージタグを固定し、手動で反映します。
  • Next.js
  • TypeScript
  • Socket.IO
  • PostgreSQL
  • Kubernetes
Wyrmtable のサイト。「Run your table together, from any browser」という見出しと、Run a game・Join a game のボタンが並ぶ暗い配色のページ。 Wyrmtable の原寸画像を開きます(新しいタブ)
公開中の Wyrmtable(wyrmtable.eu)。
小規模プロジェクト 3 件
fpl-ai · trading-harness · raid-companion
  • fpl-ai

    データ · 機械学習

    Fantasy Premier League の公式データを取り込み、期待ポイントを予測して移籍を提案します。実行はせず提案のみを行う設計です。作業の大半はデータの整備でした。単位の不一致や信頼できない上流カラムを見つけておかないと、すべての提案が静かに誤ったものになっていました。

    • Python
    • Pandas
    • Kubernetes
    稼働中
  • trading-harness

    研究 · システム

    ウォークフォワード検証、現実的な手数料とスリッページのモデル化、リスク上限、そしてエラーだけでなく無応答にも反応するアラートを備えた暗号資産の研究基盤です。結果は率直に言って優位性なし。勝率と損益比の積が 1.0、つまりランダムなエントリーと同じ特徴を示しました。それを正しく測定して手を止めたことが、さらなるチューニングよりも価値がありました。

    • Python
    • バックテスト
    • GitHub Actions
    研究
  • raid-companion

    デスクトップ · ツール

    レイド用のデスクトップ補助ツールです。単一の実行ファイルとして配布しており、利用者はインストール手順を読まずにダブルクリックするだけで使えます。

    • Electron
    • TypeScript
    • Node.js
    リリース済み

障害対応の記録

4 件の記録

何が起きて、その後どう変えたか 原因を特定し記録しています
sev-1

シンプロビジョニング領域が 100% に達し、全 VM が停止

事象
ストレージプールが完全に埋まり、書き込みが停止。ホスト上のすべての VM が同時に応答しなくなりました。
原因
ハイパーバイザーが discard=ignore で動作しており、ゲスト側の TRIM がホストに届いていませんでした。削除済みブロックが回収されず、VM 側でいくら空けてもプールは増える一方でした。
対応
discard のパススルーを有効化し、fstrim で未回収の領域を解放して使用率を上限以下に戻しました。
再発防止
プール使用率を監視対象にしたため、次に上限へ近づいたときは障害ではなく警告として届きます。回収処理を静かに無効化する設定は、切迫するまで表に出てきません。ゲスト側だけでなく経路全体を確認することが教訓です。
sev-1 メモリ不足のノードが自ら停止 解決済み
事象
ワークロードを 1 つ退避させる代わりに、ノード全体が応答しなくなりました。
原因
メモリを大量に消費するワークロードがノードの RAM を使い切りました。kubelet の退避しきい値が未設定だったため、退避を実行する余力が残る前に限界に達していました。
対応
退避しきい値とシステム予約を明示的に設定し、kubelet が常に動ける余力を確保。あわせて実測値に基づいてワークロードのリソース上限を見直しました。
再発防止
メモリを食うポッドは「ポッドの問題」で収まり、ノード全体の問題にはなりません。退避設定は障害後に足すものではなく、クラスタ構築の一部としています。
sev-2 録画システムが再起動のたびに記録を失う 解決済み
事象
アプリケーションが把握していない録画ファイルがディスク上に溜まり続け、クリーンアップが動きませんでした。
原因
録画システムのデータベースが emptyDir 上に置かれていました。Pod が再起動するたびに索引が消える一方、録画ファイル自体はディスクに残っていました。
対応
データベースを永続ボリュームへ移し、保持期間を推測ではなく実測の書き込み量に基づいて設定しました。
再発防止
「再起動しても残るはず」と考えているものには、マニフェスト上に PVC が必要です。ステートフルなワークロードはすべて同じ観点で見直しました。
sev-2 メモリ逼迫時に API サーバーが断続的にタイムアウト 解決済み
事象
API サーバーでデータストアと TLS のタイムアウトが不定期に発生し、明確なきっかけが見当たりませんでした。
原因
コントロールプレーンのノードが空きメモリをほとんど持たず、スワップもない状態でした。データストアが大きくなり、キャッシュが逼迫した状況でクエリが遅くなっていました。
対応
TLS エラーを追いかけるのではなく、ホストのメモリまで遡って原因を特定し、逼迫を解消しました。
再発防止
データストアのサイズを監視対象にし、遅延として表れる前に増加が見えるようにしました。症状は原因から何層も離れた場所に出ます。エラーを出していた指標が、見るべき指標とは限りませんでした。

次の計画

この基盤をこれからどうするか

計画段階 — まだ実装していません

2026年8月時点

  1. 01

    物理ホストをもう1台

    Longhorn はクラスタの VM 間でボリュームを複製していますが、その VM はすべて同じ Proxmox ホストの上にあります。2台に分ければ、単一障害点が本当の意味での冗長構成になり、いつも切り詰めているメモリの余裕も取り戻せます。

  2. 02

    コントロールプレーンの冗長化と、クラスタ外へのバックアップ

    コントロールプレーンが1ノードだけという点も、まず直したいところです。複数ノード構成にしたうえで、データベースのバックアップを、保護対象と同じストレージではなくクラスタの外へ送るようにします。

  3. 03

    専用ハードウェア上での推論基盤

    ローカルでのモデル実行は、ディスクと RAM を他のサービスと奪い合うようになった時点でクラスタから外しました。実際に使われているサービスから容量を借りるのではなく、専用のハードウェアで動かし直したいと考えています。

  4. 04

    n8n による AI 運用支援の再構築

    これは一度動かしていました。Alertmanager の critical アラートを n8n の Webhook に流し、ローカルモデルを呼び出して自動復旧を試みる仕組みです。6月に外して以降、critical アラートは Discord に通知するだけになっています。今度は人を介在させた形で戻したいと考えています。n8n が原因の診断と対処案を作成し、人が承認し、実行の記録が必ず残る形です。これには 03 が前提になります。推論をプロダクションと資源を奪い合わない場所に置く必要があるためです。

  5. 05

    Wyrmtable のスケールアウト

    現在セッションの状態は単一プロセスのメモリ上にあるため、アプリは1レプリカで動いています。Socket.IO の背後に Redis アダプタを置けばスケールアウトでき、次の機能としてフォグ・オブ・ウォー付きのバトルマップを予定しています。

技術スタック

実際の構築と運用で使用

インフラ

  • Proxmox
  • Terraform
  • Ansible
  • Kubernetes / K3s
  • Helm
  • Docker
  • Linux
  • MetalLB
  • Longhorn
  • cert-manager

デリバリーと監視

  • ArgoCD
  • GitOps
  • GitHub Actions
  • Prometheus
  • Grafana
  • Alertmanager
  • エクスポーター
  • n8n

アプリケーション

  • TypeScript
  • Next.js
  • React
  • Node.js
  • Socket.IO
  • Python
  • PostgreSQL
  • Electron

実務

  • Infrastructure as Code
  • 障害の原因分析
  • 災害復旧
  • キャパシティ計画
  • 監視設計
  • ドキュメント作成
連絡先 通常 1 日以内に返信します

基盤をつくり、動かし続けられる人材をお探しですか。

プロビジョニングの仕組みづくりから、深夜の原因調査まで担当します。プラットフォームエンジニアリングや Kubernetes、自宅サーバーの話まで、お気軽にご連絡ください。